《Python深度学习》笔记
前言
说起大模型,我们都知道它是通过海量数据”训练”出来的,但很少有人了解”训练”二字背后究竟发生了什么。
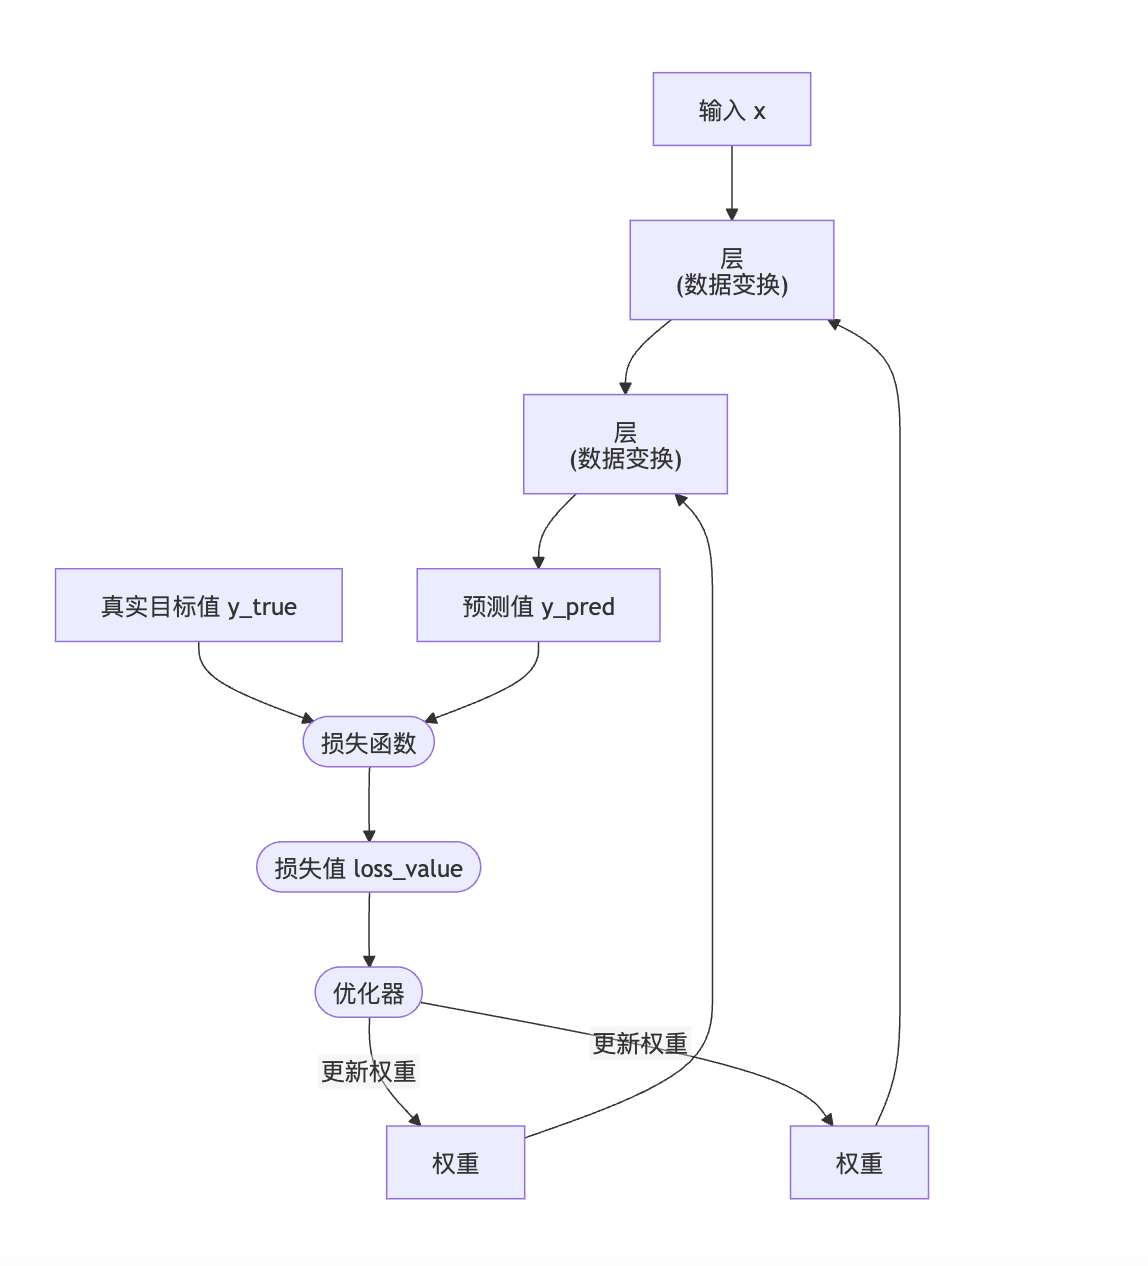
所谓”训练”,本质上是一个深度学习的过程。而实现这一过程的载体,是一种称为神经网络的模型结构——它由若干层级层叠加而成,数据在各层之间逐步传递、转化,最终从数据中学习到数据的规律与特征表示。
我们先来看一个神经网络的具体实例:MNIST 手写数字识别,该例子使用Python的Keras库实现。
如何快速训练一个神经网络
下面是用 Keras 训练一个识别手写数字(0–9)的神经网络:
1 | from tensorflow.keras.datasets import mnist |
寥寥数行代码,我们得到了一个训练好的数字识别模型,准确率约 97.8%。但是,模型训练的背后到底做了什么呢?下面我们来详细了解。
深度学习中的数据基础
神经网络的数据表示
神经网络处理的一切数据都是张量(Tensor),张量同时也可以理解为多维数组:
张量的阶(ndim)
| 阶 | 名称 | 形状示例 | 典型用途 |
|---|---|---|---|
| 0 | 标量 | () |
单个值 |
| 1 | 向量 | (512,) |
一个样本的特征 |
| 2 | 矩阵 | (60000, 784) |
向量数据:形状为(samples, features)的2阶张量,每个样本都是一个数值(“特征”)向量 |
| 3 | 3阶 张量 | (60000, 28, 28) |
时间序列数据:形状为(samples, timesteps, features)的3阶张量,每个样本都是特征向量组成的序列。 灰度图:形状为(samples, width, height)的3 阶张量,每个样本表示一个灰度图。 |
| 4 | 4阶 张量 | (64, 3, 224, 224) |
图像数据:形状为(samples, height, width, channels)的4阶张量,每个样本都是一个二维像素网格,每个像素则由一个“通道”(channel)向量表示。 |
| 5 | 5阶 张量 | (32, 10, 128, 128, 3) |
视频数据:形状为(samples, frames, height, width, channels)的5阶张量,每个样本都是由图像组成的序列(序列长度为frames)。 |
代码示例
1 | import numpy as np |
张量的三个关键属性
ndim(阶数):维度数量
shape(形状):每个维度的大小,如
(60000, 28, 28)dtype(数据类型):
float32、uint8、int64等
在开头的 mnist 数据例子中,输入数据是一个形状为 (60000, 28, 28) 的 3 阶张量,标签数据是形状为 (60000,) 的 1 阶张量。
神经网络的“齿轮”:张量运算
神经网络中的所有变换,归根结底只有几种基本运算。
逐元素运算
relu运算和加法都是逐元素运算,即该运算分别应用于张量的每个元素。
1 | def naive_relu(x): |
广播
当两个张量形状不同时,在进行运算时会自动”广播”小张量以匹配大张量的形状。
1 | x = np.random.random((64, 3, 32, 10)) # 4阶 张量 |
张量积
张量积,也叫点积。它是一种将两个不同维度的信息“展开”,”组合”成一个更大空间的方式。它必须满足以下前提条件:
| 运算类型 | 必须满足的条件 | 示例 |
|---|---|---|
| 向量点积 | 两个向量长度相等 | (n,) · (n,) |
| 矩阵乘法 | 第一个矩阵的列数 = 第二个矩阵的行数 | (m, k) @ (k, n) |
| 高维 | 指定收缩的轴的尺寸必须对应相等 | a.shape[-1] == b.shape[0](默认情况) |
代码示例:
1 | def naive_vector_dot(x, y): |
张量变形
张量变形是指重新排列张量的行和列,以得到想要的形状。变形后,张量的元素个数与初始张量相同。
代码示例:
1 | x = np.array([[0., 1.], |
回到开头的数字识别的示例中:
1 | keras.layers.Dense(512, activation="relu") |
这个层叫“全连接”神经层,实际上可以理解为一个函数,其输入是一个张量,返回是另一个新的张量:
1 | output = relu(dot(input, W) + b) |
该函数涉及了2 种张量运算:点积运算、逐元素运算(relu 和 加法都是逐元素运算,relu 的作用是为了引入非线性)。
神经网络的“引擎”:基于梯度的优化
先来复习下几个基本概念:
导数
导数最经典的几何意义就是:曲线在某一点的切线斜率。
对于函数
y = f(x),它的图像是一条曲线。在曲线上取一点
x_0,过这一点画一条切线。这条切线的斜率,就是函数在
x_0处的导数f'(x_0)。
直观理解:
- 斜率 > 0:x 的微增将导致 y 变大;
- 斜率 < 0:x 的微增将导致 y 变小;
- 斜率 = 0:处于水平状态(可能是极值点)
- 斜率的绝对值越大:变化越陡峭
梯度
张量运算的导数叫作梯度(gradient)。在深度学习中,它可以表示为,当输入参数发生变化时,张量函数的输出如何变化。
梯度下降法
回到“全连接”神经层的这个函数:
1 | output = relu(dot(input, W) + b) |
在这个表达式中,W和b是张量,均为该层的属性。它们被称为该层的权重(weight)或可训练参数(trainableparameter)。这些权重就是模型从训练数据中学到的信息,这些信息是如何学习得到的呢?
一开始,这些权重会随机初始化(random initialization);
抽取训练(input)样本 x 和对应的目标值 y_true (预期 output)组成的数据批量;
在 x 上运行“全连接”神经层中的函数,得到预测 y_pred 值(实际 output),这一步也叫前向传播;
计算 y_pred 和 y_true 的损失值 loss_value,用于衡量 y_pred 和 y_true 的差距;
更新模型的权重,减小 y_pred 和 y_true 的损失值 loss_value;
当得到的 y_pred 与 y_true 之间的差距(loss_value)足够小时,这个时候的模型便已经学会了如何将将输入映射到正确的输出。
而这个过程,就是“深度学习”的“训练”过程。
问题在于第 5 步,对于模型的某个权重,如何能知道这个系数该增大还是该减小,以及变化多少呢?
梯度下降法就是做这个事情的方法。
实际上整个“训练”过程,我们只有一个目的,就是降低损失值 loss_value。回顾“训练”的计算过程,其涉及的函数变换,大致可以表示如下:
1 | y_pred = relu(dot(input, W) + b) |
如果输入数据 input 和 y_true 保持不变,那么可以将前面的运算看作一个将模型权重 W 和 b 的值映射到损失值 loss_value 的函数:
1 | loss_value = f(W, b) |
此时该函数描述的是,W 和 b 变化时,loss_value 如何变化形成的曲线。但如何能知道怎么才能让 loss_value 往小的方向变化呢?答案也呼之欲出了,那就是先求 f(W, b) 函数的梯度,只要知道了梯度,就知道 loss_value 变化的方向(也叫反向传播),此时就可以沿着变化相反的方向调整 (W, b),从而达到让 loss_value 减小的目的,而这个整个过程也叫梯度下降。
模型训练的本质
现在我们可以完整地描述”训练一个神经网络”这件事了:模型由许多层链接在一起组成,并将输入数据映射为预测值。随后,损失函数将这些预测值与目标值进行比较,得到一个损失值,用于衡量模型预测值与预期值之间的差距。优化器将利用这个损失梯度来更新模型的权重。